
喜讯!ARClab团队论文被国际顶级会议ICDE录用
浙江大学计算机系统结构实验室(ZJU ARClab)二年级博士生袁新宇的论文《On the (Generative) Linear Sketching Problem》于2026 年 9 月被数据库和数据挖掘CCF A类会议 IEEE International Conference on Data Engineering(IEEE ICDE)正式录用。该论文在陈文智老师和王总辉老师的共同指导下完成,首次将概率生成思想纳入流式摘要算法与系统的设计之中,提出了一个创新性方案——FLORE。
会议介绍
IEEE International Conference on Data Engineering(ICDE)是数据库、数据管理与数据工程领域的顶级国际学术会议,也是IEEE计算机学会数据工程技术委员会(TCDE)主办的重要学术会议之一。ICDE,SIGMOD和VLDB三者长期聚焦数据管理系统、数据库技术、分布式与云数据管理、数据挖掘与知识发现、图数据以及人工智能与数据系统等前沿方向,在数据库与数据工程领域具有广泛的国际影响力。ICDE被中国计算机学会(CCF)列为数据库/数据挖掘领域A类国际会议,具有较高的学术认可度。会议实行严格的同行评审机制,对论文的原创性、技术创新性、理论分析和实验验证均有较高要求;本届会议First Round录用率大约19%。
研究背景
想象一下,当消防水龙带的高压水柱直冲面门时,你很难去精准计量水量。从某种意义上说,这正是分析流式数据所面临的挑战:数据如洪流般向我们袭来,且从未停歇。如果你正在刷 Twitter,看着推文飞速划过,你可能会希望让时间短暂暂停,好让你弄清楚当下的热点是什么。但这并不可行,所以你需要找到一种方法,能够实时统计那些不断涌现的标签。执行这类即时计算的计算机程序被称为“流式算法”。由于数据连续不断地涌入,且体量巨大,这些算法会尝试记录所见数据的精髓,同时策略性地遗忘其余部分。三十多年来,机器学习和数据库系统的学者们一直致力于构建更优秀的流式算法。
理论洞察
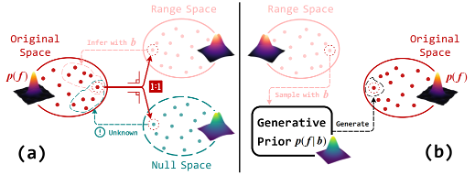
要理解 FLORE 的价值,首先必须直面传统流式摘要的”阿喀琉斯之踵”。经典的随机近似方法,如 Count-Min Sketch 或Count Sketch,在恢复数据时存在一个致命的逻辑缺陷:它们只观察摘要矩阵的 k 个条目,却忽略了其他所有 key 的影响。从压缩感知的角度看,这些 sketching 矩阵的 RIP 距离极大,而理想的随机稠密矩阵只需 O(s·log(N/s)) 个计数器,稀疏矩阵则需要O(s²) 个。这意味着,为了维持精度,稀疏 sketching 矩阵被迫使用了远多于理论最优值的计数器,造成了极大的资源浪费。对任意线性系统,任意向量可唯一分解为值空间分量和零空间分量。摘要过程只能恢复值空间分量,而零空间分量的信息在摘要过程中永久丢失。这就是”正交信息丢失”的本质——零空间分量的丢失是不可逆的。无论你的哈希函数设计得多么精妙,只要它是线性的,这部分信息就注定消失在压缩的黑洞中。如果我们能学会数据分布的生成模型,就可以用先验知识”猜出”零空间中丢失的那部分信息,从而桥接值空间与零空间之间的鸿沟。我们不再是在”恢复”数据,而是在基于摘要和先验”重构”数据。研究团队在合成数据上测试了 VAE、GAN、WGAN、FGM、扩散模型等多种生成式架构。除了基于流的生成模型(FGM),其他模型在扩展到真实场景时均面临训练不稳定、推理慢、表达能力差等问题。FGM 凭借其精确可逆映射和可处理似然评估的特性,成为唯一能同时满足”恢复精度”与”训练可行性”的选择。它不是黑盒,而是一个数学上严谨的可逆求解器。
系统实现
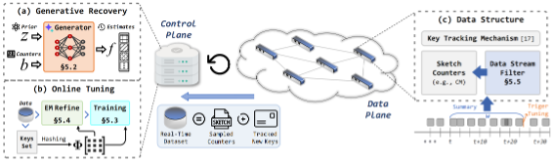
FLORE 采用了经典的数据面-控制面分离设计,将”快”与”准”解耦:1. 数据面(Data Plane):极致轻量。使用增强过滤器存储高频项、Count-Min Sketch 存储低频项、Bloom Filter 追踪 key。这一层几乎不增加原有系统的时空开销。2. 控制面(Control Plane):智能中枢。部署生成模型进行恢复和在线调优,不受数据面计算资源的严格限制。这种架构的精髓在于:将学习到的模型放在控制面,数据面的摘要过程和时空效率基本保持不变,但系统的整体恢复能力却实现了质的飞跃。面对海量数据,FLORE 引入了分段策略。将大规模数据流分解为多个小段独立处理,在 500K 唯一 key 的规模下,参数量减少 200 倍以上。此外,FLORE 最具工程价值的突破:它可以在不访问真实标签的情况下训练。
FLORE 在多个真实和生成数据集上进行了全面评估,结果令人震撼。1. 精度明显提升:32 倍内存压缩。FLORE 在元素级频率估计上显著优于所有基线。在 CAIDA 网络流量数据集上,仅 64KB 内存预算就能达到竞争方法在 2MB 内存下才有的保真度。这意味着内存 footprint 减少了 32 倍。在 heavy hitter 检测和 Top-k 热点元素发现上,FLORE 的 F1 Score 全面领先。相比现有的学习类方案,误差最高降低 103 倍。2. 速度领先:从秒级到毫秒级。数据面摘要吞吐量:FLORE 比基线快 2%~162%,几乎没有额外开销。控制面恢复速度:比 LSQR/LCM/LCS 等传统迭代方法快 5.87x~27.61x(GPU 加速),比 PR/ES 快 169.67x。大规模场景:在 500K unique keys 规模下,FLORE(1MB 内存)仅需约 100ms,而 LSQR(128KB)需要数秒。相比学习类方案,处理速度最高提升 102 倍。
作者介绍
论文第一作者袁新宇为浙江大学计算机系统结构实验室2025级博士生,主要研究方向为机器学习,网络测量,网络管理和优化等。